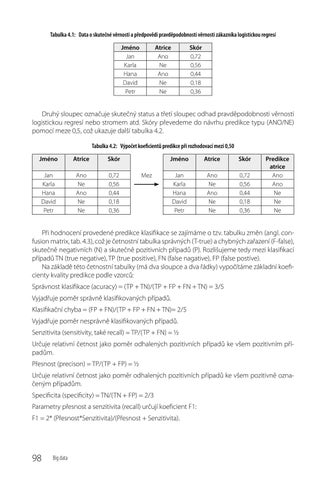
Tabulka 4.1: Data o skutečné věrnosti a předpovědi pravděpodobnosti věrnosti zákazníka logistickou regresí Jméno Jan Karla Hana David Petr
Atrice Ano Ne Ano Ne Ne
Skór 0,72 0,56 0,44 0,18 0,36
Druhý sloupec označuje skutečný status a třetí sloupec odhad pravděpodobnosti věrnosti logistickou regresí nebo stromem atd. Skóry převedeme do návrhu predikce typu (ANO/NE) pomocí meze 0,5, což ukazuje další tabulka 4.2. Tabulka 4.2: Výpočet koeficientů predikce při rozhodovací mezi 0,50 Jméno
Atrice
Skór
Jan Karla Hana David Petr
Ano Ne Ano Ne Ne
0,72 0,56 0,44 0,18 0,36
Jméno
Atrice
Skór
Jan Karla Hana David Petr
Ano Ne Ano Ne Ne
0,72 0,56 0,44 0,18 0,36
Mez
Predikce atrice Ano Ano Ne Ne Ne
Při hodnocení provedené predikce klasifikace se zajímáme o tzv. tabulku změn (angl. confusion matrix, tab. 4.3), což je četnostní tabulka správných (T‑true) a chybných zařazení (F‑false), skutečně negativních (N) a skutečně pozitivních případů (P). Rozlišujeme tedy mezi klasifikací případů TN (true negative), TP (true positive), FN (false nagative), FP (false postive). Na základě této četnostní tabulky (má dva sloupce a dva řádky) vypočítáme základní koeficienty kvality predikce podle vzorců: Správnost klasifikace (acuracy) = (TP + TN)/(TP + FP + FN + TN) = 3/5 Vyjadřuje poměr správně klasifikovaných případů. Klasifikační chyba = (FP + FN)/(TP + FP + FN + TN)= 2/5 Vyjadřuje poměr nesprávně klasifikovaných případů. Senzitivita (sensitivity, také recall) = TP/(TP + FN) = ½ Určuje relativní četnost jako poměr odhalených pozitivních případů ke všem pozitivním případům. Přesnost (precison) = TP/(TP + FP) = ½ Určuje relativní četnost jako poměr odhalených pozitivních případů ke všem pozitivně označeným případům. Specificita (specificity) = TN/(TN + FP) = 2/3 Parametry přesnost a senzitivita (recall) určují koeficient F1: F1 = 2* (Přesnost*Senzitivita)/(Přesnost + Senzitivita).
98
Big data
Ukázka elektronické knihy, UID: KOS505074
Jde o harmonický průměr přesnosti a senzitivity. Vyjadřuje poměr potvrzených negativních případů ke všem negativním případům. Tabulka 4.3: Příklad tabulky změn
Pozitivní Predikovaný status
Negativní
Skutečný status Pozitivní (zůstane) Negativní (zůstane) Správně pozitivní (TP): Nesprávně pozitivní (FP): Jan Hana Nesprávně negativní (FN): Správně negativní (TN): Karla David, Petr
Poznamenejme, že zjištěné četnosti závisí na hodnotě meze. Například pro mez 0 (1) se klasifikační přesnost změní na 40 % (60 %), chyba na 60 % (40 %), senzitivita na 100 % (0 %) a specificita na 0 % (100 %). Můžeme konstruovat také tabulku se senzitivitou, specificitou a 1 – specificitou pro různé hodnoty meze. To vede k často uváděné ROC křivce. ROC křivka (ROC – Receiver Operating Characteristic) znázorňuje senzitivitu proti 1 – specificitě pro všechny možné hodnoty rozhodovací meze číselného skóre (obr. 4.22).
Obrázek 4.22: ROC křivka
Dokonalý model má senzitivitu 1 a specificitu 1 a je prezentovaný horním levým rohem grafu. Čím je křivka bližší tomuto bodu, tím je kvalita klasifikační procedury lepší. Obvykle s klesající specificitou stoupá senzitivita. Jestliže klasifikační procedura (např. logistická regrese) nemá žádnou diskriminační schopnost, pak je ROC blízko přímky, která na grafu spojuje body (0; 0) a (1; 1). Čím je od této přímky ROC křivka vzdálenější, tím je diskriminační schopnost větší. Na grafu pro srovnání dvou klasifikačních procedur se nalézají dvě takové ROC křivky. Problém vzniká, když se křivky dvou procedur protínají. Pak je vhodné použít jako míru kvality predikce (výkonu) koeficient AUC (Area Under Curve). AUC poskytuje jednoduchý shrnující index výkonu procedury. Čím je větší AUC, tím je lepší kvalita klasifikační procedury. AUC má hodnotu vždy mezi nulou a jedničkou, v procentech mezi nulou a stem. Jinou hodnotící mírou je Gini koeficient, který je definován jako poměr: (Plocha pod křivkou – plocha pod náhodným modelem)/ (Plocha pod dokonalým modelem – plocha pod náhodným modelem) V dokonalém modelu má Gini koeficient hodnotu 1 a náhodný model má hodnotu 0. Platí rovnice Gini koeficient = 2 AUC ‑1.
Strojové učení – přehled
99 Ukázka elektronické knihy, UID: KOS505074
Koeficient AUC se zobecňuje také pro klasifikační úlohy s více třídami tak, že se vynese ROC křivka jedné třídy proti všem ostatním. To se provede pro všechny třídy a pak se vypočítá průměr z takto získaných AUC koeficientů. Upozorňujeme, že v mnoha případech (např. při hodnocení klinických testů, které nabývají pouze dvě hodnoty) se opíráme o jednu tabulku změn a z ní počítáme všechny charakteristiky. Také používáme termíny správná pozitivita predikce (TPR, true positive rate), správná negativita predikce (TNR, true negative rate), falešná negativita predikce (FNR), falešná pozitivita predikce (FPR). TPR = správná pozitivita predikce = TP/(TP+FP) = přesnost TNR = správná negativita predikce = TN/(TN+FN) FPR = falešná pozitivita predikce = FP/(TP+FP) FNR = falešná negativita predikce = FN/(TN+FN) Existuje vztah mezi některými těmito mírami: FNR = 1 – TNR, FPR = 1 – TPR. Musíme zvažovat, které četnosti jsou předem dané a které se mění náhodně, aby odhadnuté koeficienty dávaly smysl v reálné situaci. Poznamenejme, že při klasifikaci do r kategorií postupujeme analogicky. Sestrojíme četnostní čtvercovou tabulku změn, která má r řádků a sloupců a na její diagonále jsou správně klasifikované případy.
4.7.2
Ukazatele kvality regresních modelů
U regresních modelů, kdy odhadujeme spojitou závisle proměnnou, je základní klíčová metrika kvality koeficient determinance R2.
R
2
∑ = 1− ∑
n i =1 n i =1
( yi − y i ) 2 ( yi − y i ) 2
kde yi je správná hodnota, predikovaná hodnota a průměr ze všech hodnot. Hodnota R2 leží mezi čísly 0 a 1, hodnoty bližší číslu 1 indikují dobrý odhad. Také se používají míry jako průměrná kvadratická odchylka MSE (mean squared error) nebo průměrná absolutní odchylka MAD (mean absolute deviation):
∑ MSE =
n i =1
∑ MAD =
( yi − y i ) 2
n i =1
n
yi − y i
2
n
U číselné predikce pomocí regrese se často jako míra kvality počítá Pearsonův nebo Spearmanův koeficient korelace mezi predikcí a skutečnou hodnotou. Neuvažuje se přitom systematická chyba.
4.7.3
Interpretovatelnost prediktivních modelů
Porozumění tomu, proč se modely strojového učení chovají určitým způsobem, je důležité pro jejich autory i uživatele. Přitom jde o výběr modelu, výběr a přípravu atributů, o důvěru
100
Big data Ukázka elektronické knihy