98
Big Data a NoSQL databáze
Namespace User Klíč:
userID
Hodnota:
userProfile sessionData shoppingCart item 1 item 2
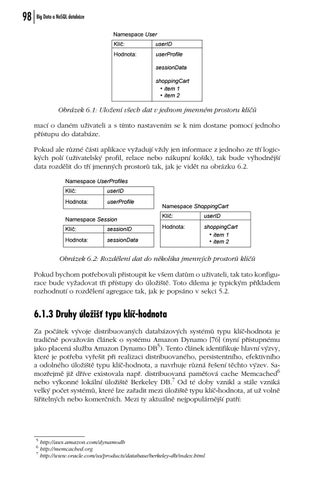
Obrázek 6.1: Uložení všech dat v jednom jmenném prostoru klíčů mací o daném uživateli a s tímto nastavením se k nim dostane pomocí jednoho přístupu do databáze. Pokud ale různé části aplikace vyžadují vždy jen informace z jednoho ze tří logických polí (uživatelský profil, relace nebo nákupní košík), tak bude výhodnější data rozdělit do tří jmenných prostorů tak, jak je vidět na obrázku 6.2. Namespace UserProfiles Klíč:
userID
Hodnota:
userProfile
Namespace Session Klíč:
sessionID
Hodnota:
sessionData
Namespace ShoppingCart Klíč:
userID
Hodnota:
shoppingCart item 1 item 2
Obrázek 6.2: Rozdělení dat do několika jmenných prostorů klíčů Pokud bychom potřebovali přistoupit ke všem datům o uživateli, tak tato konfigurace bude vyžadovat tři přístupy do úložiště. Toto dilema je typickým příkladem rozhodnutí o rozdělení agregace tak, jak je popsáno v sekci 5.2.
6.1.3 Druhy úložišť typu klíč-hodnota Za počátek vývoje distribuovaných databázových systémů typu klíč-hodnota je tradičně považován článek o systému Amazon Dynamo [76] (nyní přístupnému jako placená služba Amazon Dynamo DB5). Tento článek identifikuje hlavní výzvy, které je potřeba vyřešit při realizaci distribuovaného, persistentního, efektivního a odolného úložiště typu klíč-hodnota, a navrhuje různá řešení těchto výzev. Samozřejmě již dříve existovala např. distribuovaná paměťová cache Memcached6 nebo výkonné lokální úložiště Berkeley DB.7 Od té doby vznikl a stále vzniká velký počet systémů, které lze zařadit mezi úložiště typu klíč-hodnota, ať už volně šiřitelných nebo komerčních. Mezi ty aktuálně nejpopulárnější patří:
5
http://aws.amazon.com/dynamodb http://memcached.org 7 http://www.oracle.com/us/products/database/berkeley-db/index.html 6
Ukázka elektronické knihy, UID: KOS215002
NoSQL databáze
99
• knihovny pro tvorbu vestavěných diskových úložišť jako Berkeley DB, LevelDB,10 RocksDB11 nebo MapDB,12 • paměťové cache jako Memcached, Ehcache13 nebo Hazelcast.14
6. Databáze typu klíč-hodnota
• persistentní distribuované systémy jako Riak, Redis8 nebo Infinispan,9
Pro aktuální bohatý seznam systémů typu klíč-hodnota doporučujeme například stránky DB-Engines.com.15
6.2 Realizace a vlastnosti V této sekci se zaměříme na vybrané vlastnosti a výzvy, které se týkají většiny databázových systémů typu klíč-hodnota, a popíšeme principy jejich řešení v současných implementacích.
6.2.1 Distribuce dat Většina systémů typu klíč-hodnota může pracovat v distribuovaném režimu, kdy jsou data rozdělena mezi více uzlů distribuovaného systému (viz sekce 3.3.1). Rozhodnutí o tom, na který uzel bude uložena dvojice (key, value), je učiněno buď přímo podle konkrétního klíče key, nebo podle hodnoty hašovací funkce hash(key). Nabízí se použití poměrně standardního přístupu, kdy bychom klíč přidělili danému serveru na základě zbytku po dělení hašované hodnoty počtem uzlů M, tedy hash(key) mod M (viz obrázek 6.3). Tímto přístupem lze dosáhnout rovnoměrného rozložení hodnot mezi uzly a je ho možné dobře použít, pokud se množina uzlů nemění. Pokud ale například přidáme do systému jeden uzel, změní se hodnota M, tím i výsledky operace modulo a bylo by potřeba přesunout prakticky všechna data na jiné uzly. číslo uzlu = hash(key) mod M uzel 0
uzel 1
uzel 2
uzel 3
? (key, value)
Obrázek 6.3: Princip standardního hašování založeného na operaci modulo
8
http://redis.io http://infinispan.org 10 https://github.com/google/leveldb 11 http://rocksdb.org 12 http://mapdb.org 13 http://ehcache.org 14 http://hazelcast.com 15 http://db-engines.com/en/ranking/key-value+store 9
Ukázka elektronické knihy, UID: KOS215002
100
Big Data a NoSQL databáze
Využití přístupu „zbytek po dělení“ Přestože rozdělení dat pomocí zbytku po dělení trpí zmíněnou „statičností“, v praxi se efektivně využívá. Např. Elasticsearch při ukládání dokumentu získá zbytek po dělení hašované hodnoty směrovacího klíče (routing value) – kterým je implicitně identifikátor dokumentu – počtem primárních oddílů indexu (shards ), a uloží dokument do příslušného oddílu. Směrovací klíč přitom může uživatel definovat, takže má kontrolu nad distribucí dat, např. vzhledem k dodržení principu lokality, tj. ukládání dat, která k sobě patří, společně. Zmíněná „statičnost“ uložení dat se konkrétně projevuje nemožností změnit počet primárních oddílů databáze (primary shards) po jejím vytvoření – při změně počtu primárních oddílů bychom pro stejnou hodnotu získali jiný zbytek po dělení. Doplňme, že jiné obdobné systémy, např. Solr,16 disponují funkcí rozdělení primárních oddílů (shard splitting ), ale platí za to relativně vysokou cenu: taková operace bude vždy náročná na prostředky a výpočetní kapacitu, a od jistého objemu dat bude prakticky neproveditelná. Doplňme, že v kontextu Elasticsearch je zmíněná nevýhoda prakticky neutralizována v okamžiku, kdy si uvědomíme, že data nemusíme ukládat do jediné databáze (v terminologii Elasticsearch indexu), ale do několika, a můžeme s nimi pracovat jako s jedním logickým celkem. To nám přináší zcela zásadní výhodu v tom, že můžeme přidávat (a samozřejmě též odebírat) další databáze (indexy), podle toho, jak roste objem dat. Protože v kontextu Big Data často předem nevíme, kolik výpočetní kapacity bude potřeba, je vhodné mít efektivní možnosti, jak dělit data dynamicky. Proto se často využívá princip konzistentního hašování (consistent hashing) [112], ve kterém je každý uzel zodpovědný za souvislý interval (nebo intervaly) hašovacích klíčů. Jak toho dosáhnout ilustruje obrázek 6.4 na následující straně. Každému uzlu v systému je přiřazen hašovací klíč ze stejné domény, kterou má hašovací funkce na klíčích (v našem příkladu má doména rozsah [0, 2160 − 1]). Každý uzel pak spravuje všechny klíče v intervalu mezi klíčem předcházejícího uzlu a svým klíčem. Hašovací prostor na obrázku je zobrazen jako kruh, protože interval mezi dvěma uzly může přecházet přes nulu (viz interval mezi uzly E a A). V případě přidání nového uzlu mu systém také přidělí klíč z domény hašovací funkce, čímž se rozštěpí právě jeden interval klíčů mezi dvěma existujícími uzly. Fyzicky jsou pak z existujícího uzlu přesunuta data příslušející nově příchozímu uzlu a žádná další data v systému není nutné přesouvat. Pro rozšíření informace o změně v množině uzlů se používají tzv. gossip protokoly (česky doslova klepy nebo drby ). Název této rodiny protokolů poměrně dobře vystihuje jejich podstatu: každý uzel v pravidelných časových intervalech vybere náhodně jeden ze svých známých uzlů, který kontaktuje a předá mu „novinky“ – v našem případě aktuální informace o uzlech v distribuovaném systému. Podle matematického modelu šíření epidemie [61] se tímto způsobem informace rozšíří 16
http://lucene.apache.org/solr/
Ukázka elektronické knihy, UID: KOS215002